L'economia del calcolo utile per l'IA: silicio efficiente e bolletta energetica maggiore possono coesistere
Un'analisi di domanda, efficienza dei modelli, HBM, reti, utilizzo utile, energia e recupero del capitale. Fonti recenti e scenari riproducibili mostrano quando
Gruppo di Ricerca ed Editoriale Voltformer · Evidenze consultate il 22 ottobre 2026 · Analisi con scenari condizionali esplicitamente indicati
L'infrastruttura IA entra in una fase economica difficile: chip e modelli riducono le risorse richieste da determinati calcoli mentre gli investitori impegnano più capitale nelle macchine che li eseguono. Conta quante attività economicamente utili il sistema completi, con qualità e ritardo accettabili, durante la vita operativa. Potenza aritmetica di picco, megawatt annunciati e token grezzi misurano ciascuno solo una parte.
La tesi è condizionale. L'efficienza aumenta il valore della capacità installata se domanda, software e infrastrutture assorbono il miglioramento. Riduce il bisogno di nuova capacità se la domanda satura o sistemi piccoli sostituiscono quelli grandi. L'esito dipende da risposta della domanda, distribuzione dei lavori, utilizzo effettivo e tempi degli impegni. Nessuna legge fisica impone che un token più economico riduca l'elettricità totale o giustifichi ogni acquisto previsto.
1. Che cosa stabiliscono le ultime fonti primarie
I risultati TSMC del 15 ottobre indicano ricavi trimestrali di USD 46.72 miliardi; la tecnologia a 2 nanometri genera l'8% dei ricavi da wafer. Descrivono vendite e composizione produttiva, non sistemi IA installati. TSMC, terzo trimestre 2026.
NVIDIA riporta USD 89.0 miliardi di ricavi Data Center nel trimestre concluso il 26 luglio, in aumento del 117% annuo. Ricavi forti dimostrano acquisti; la redditività del cliente richiede altre prove. NVIDIA, secondo trimestre fiscale 2027.
| Evidenza datata | Osservazione o dichiarazione | Classificazione | Che cosa resta da provare |
|---|---|---|---|
| 29 luglio: SK hynix | Spedizioni HBM4 di massa avviate in Q2 | Sviluppo operativo dichiarato dall'impresa | Volumi qualificati per ogni cliente comunicato |
| 30 settembre: Micron | Investimenti netti FY2026 di USD 27.367 miliardi | Misura non GAAP comunicata | Produzione e resa della capacità futura risultati e riconciliazione |
| 17 settembre: MLCommons | Inference v6.1 aggiunge RAG completo e Agentic Edge | Pubblicazione di benchmark | Economia del lavoro produttivo dell'operatore analisi |
| 12 ottobre: AMD | Helion integra calcolo configurabile e selezione dei modelli | Annuncio di prodotto | Flotta installata ed efficienza ottenuta annuncio |
| 19 ottobre: Meta | Prima fase Prometheus completata e usata per addestramento | Installazione comunicata dall'operatore | Utilizzo dell'intero settore resoconto tecnico |
| 21 ottobre: Meta | Previsione investimenti FY2026 ristretta a USD 135–145 miliardi, incluso capitale dei leasing finanziari | Previsione manageriale | Rendimento realizzato risultati |
La matrice è volutamente eterogenea: risultati finanziari, operazioni, ricerca e annunci rispondono a domande diverse. Trattarli come intercambiabili suggerisce falsamente che tutte le fasi tra ordine dei wafer e servizio redditizio siano completate.
2. La domanda va misurata in attività completate
Il token è un'unità contabile ingegneristica, non un'unità costante di produzione economica. Tokenizzatori diversi dividono diversamente lo stesso materiale. Una risposta lunga può aggiungere valore o spreco. Un agente può ripetere chiamate aspettando strumenti, ritentando esecuzioni o rivedendo il lavoro. Il ricavo per token dipende anche da sconti, cache e mix di entrate e uscite.
Un modello utile distingue arrivi delle attività, chiamate per attività, lunghezze e probabilità di completamento. Per attività fisse, più ragionamento può aumentare calcolo riducendo revisione umana. Un modello piccolo può eliminare quasi tutto quel calcolo senza ridurre i successi. Entrambe le possibilità vanno verificate sulla distribuzione reale del cliente.
Definire l'attività accettata con correttezza valutata esternamente, limite di latenza e regole di escalation. Registrare tempo di acceleratori e CPU ed energia di tutti i tentativi. Più token del fornitore possono non migliorare il costo per successo del cliente. Meno token possono migliorarlo evitando generazioni inutili. Uso e produttività vanno dunque comunicati separatamente.
3. Il rendimento del silicio è un flusso vincolato
Roofline collega prestazioni aritmetiche raggiungibili, capacità di calcolo, banda di memoria e intensità aritmetica. Operazioni al secondo non possono superare il minimo tra picco e byte al secondo moltiplicati per operazioni per byte. È un limite per capire vincoli, non una promessa applicativa. Williams, Waterman e Patterson, Berkeley, 2008.
Per acquistare IA, estendere il ragionamento all'intero sistema. Elaborazione dell'input, generazione, instradamento agli esperti e comunicazione impongono esigenze diverse. Un motore rapido non compensa memoria insufficiente. Una rete libera non elimina dipendenze sequenziali. Acceleratori in attesa di firmware, qualificazione della rete o collaudo non producono lavoro consegnato.
| Vincolo | Unità rilevante | Conseguenza economica | Verifica richiesta |
|---|---|---|---|
| Calcolo matriciale | Operazioni/s alla precisione indicata | Un limite dell'esecuzione | Stesso modello, precisione e accuratezza |
| Capacità di memoria | Byte per pesi e stato | Limita residenza e concorrenza | Capacità netta degli oneri di esecuzione |
| Movimento della memoria | Byte/s sostenuti | Può governare la generazione | Tracce applicative, non picco dei collegamenti |
| Collegamenti interni e tra nodi | Byte/s e latenza | Cambiano sincronizzazione e inattività | Operazioni collettive con contesa realistica |
| Affidabilità | Lavoro completato per intervallo | Governa l'output utile installato | Riavvii, salvataggi e scorte |
| Domanda commerciale | Attività accettate/ora | Determina ricavi della capacità tecnica | Uso pagato e coorti di rinnovo |
I vincoli interagiscono. Lotti maggiori riutilizzano pesi ma possono peggiorare risposta. Distribuire il modello risolve capacità aggiungendo comunicazione. La configurazione preferibile è sulla frontiera qualità, ritardo e costo; il massimo pubblicizzato può esserne fuori.
4. Scarsità HBM e compressione agiscono insieme
Capacità e banda HBM sono vincoli distinti. Comprimere lo stato può aumentare richieste concorrenti, ma non elimina automaticamente lettura dei pesi e scambio dei token. Lotti grandi trasformano memoria risparmiata in prestazioni; contesti lunghi possono assorbirla.
Il preprint DeepSeek-AI V4.1-Flash del 17 settembre riporta cache KV globale residente in HBM di 890 byte per token, circa un quarto di V4-Flash, distinguendo stato persistente esterno. È una dichiarazione di ricerca specifica, senza risparmio elettrico di flotta verificato indipendentemente. Rapporto tecnico DeepSeek-AI V4.1-Flash, v1.
L'effetto economico cambia la rendita di scarsità della memoria per alcuni lavori. Se la domanda entra in meno dispositivi, si può rinviare l'acquisto. Se contesto o concorrenza la limitavano, diventano possibili servizi nuovi. La domanda di memoria può restare forte con compressione rapida, soprattutto quando nuove applicazioni richiedono più stato o più attività diventano accessibili.
Per decidere, chiedere quale livello di memoria si risparmia, se ricostruire lo stato richiede calcolo e se lo scarico sposta pressione su memoria host, dischi o rete. Meno byte HBM per richiesta è utile; il valore dipende dal prossimo vincolo.
5. Il software di erogazione cambia il denominatore
PagedAttention gestisce cache KV variabili con meno frammentazione e duplicazione. Migliora l'allocazione, non la capacità aritmetica nominale della GPU. Kwon e colleghi, PagedAttention/vLLM, 2023.
Nel maggio 2026 Google descrive un'implementazione UCSD di decodifica speculativa a diffusione su TPU, con incremento medio di 3.13 volte nei token al secondo nel confronto indicato. È una misura del lavoro specifico, non un moltiplicatore energetico universale. Google Developers, DFlash.
La speculazione aggiunge bozze per ridurre iterazioni costose del modello principale. Dipende da accettazione, compatibilità e lotti. La quantizzazione riduce dati ma deve conservare qualità. L'instradamento evita chiamate grandi, ma gli errori possono richiedere escalation. Separare preparazione e generazione adatta risorse aggiungendo trasferimento di stato.
Non moltiplicare accelerazioni pubblicate in prove separate. Due ottimizzazioni possono rimuovere lo stesso collo, competere per memoria o perdere vantaggio con altri lotti. Rimisurare il sistema combinato sul traffico previsto, con latenza di coda e recupero guasti. Il confronto giusto è la migliore alternativa fattibile, non un passato non ottimizzato.
La matematica è istruttiva. Se metà del tempo migliora dieci volte e il resto è invariato, il guadagno è 1 / [0.5 + 0.5/10] = 1.818, non dieci volte. Con quota invariata a e accelerazione s, il limite è 1 / [a + (1−a)/s]. Strumenti e comunicazione possono essere la parte invariata. Si assumono nessuna sovrapposizione e nessun lavoro aggiuntivo: serve a chiarire il denominatore, non prevedere un sistema.
6. Utilizzo ha significati incompatibili
Occupazione, allocazione, tempo programmato, lavoro utile di addestramento e utilizzo remunerato sono distinti. Una GPU allocata può attendere dati. Un kernel completato può appartenere a un lavoro poi riavviato. Una richiesta riuscita può consumare crediti promozionali gratuiti.
Il resoconto Meta di ottobre riporta oltre l'85% di rendimento utile nel preaddestramento e oltre il 90% nel rinforzo. Descrive 37,656 GPU predisposte per 32,768 attive. Il calcolo dà 14.9% di inventario aggiuntivo rispetto alle attive, oppure 13.0% di riserva sul predisposto: denominatori diversi. Nessuno stima l'utilizzo settoriale. Meta, Prometheus.
Le riserve possono essere razionali: aumentano capitale per dispositivo attivo e riducono perdite attese da interruzione. Domini di guasto grandi aumentano il valore dell'affidabilità; le scorte possono migliorare l'output utile riducendo una misura superficiale di utilizzo. Contare tutte le apparecchiature e il lavoro perso nello stesso periodo. Non moltiplicare rendimento e riserva senza conoscerne denominatori e sovrapposizioni.
7. Dai token per joule al costo erogato
MLCommons richiede che la potenza validata copra l'AC media dell'intero sistema alla presa; TDP e targa dell'alimentatore non sono quella misura. Le categorie separano inoltre sistemi disponibili, anteprime e configurazioni di ricerca. Metodologia MLPerf Inference Datacenter.
Il resoconto NVIDIA di luglio presenta fino a dieci volte più prestazioni agentiche per energia su un lavoro interno a miscela di esperti da duemila miliardi di parametri. Definisce il confronto del produttore; non dimostra bollette dieci volte inferiori per tutti. NVIDIA, architettura Rubin.
L'energia del sito aggiunge raffreddamento e perdite. Il costo aggiunge recupero del capitale, manutenzione, esercizio e capacità pronta. Il carbonio dipende anche da orario e luogo dell'elettricità. Contratti o certificati annui non misurano da soli le emissioni marginali di un'inferenza. Servono colonne separate.
Per un blocco ipotetico, siano utilizzo u, mantenimento dell'output produttivo g, produzione attiva R token/s, potenze IT medie inattiva e attiva P0 e P1 kW e moltiplicatore ausiliario h. Con 8,760 ore e 31,536,000 secondi per anno ipotizzato:
T = R × u × g × 31,536,000 token/anno
E = h × [P0 + u(P1 − P0)] × 8,760 kWh/anno
C_million = 1,000,000 × [K/L + F + pE] / T dollari per milione di token mantenuti.
K è capitale in dollari; L, recupero lineare in anni; F, costo fisso annuo; p, dollari/kWh. Si escludono finanziamento, imposte e residuo. Tutta l'energia inattiva è assegnata al blocco; g considera output perso senza ridurre energia già spesa.
8. Scenario riproducibile: l'utilizzo può dominare la tariffa
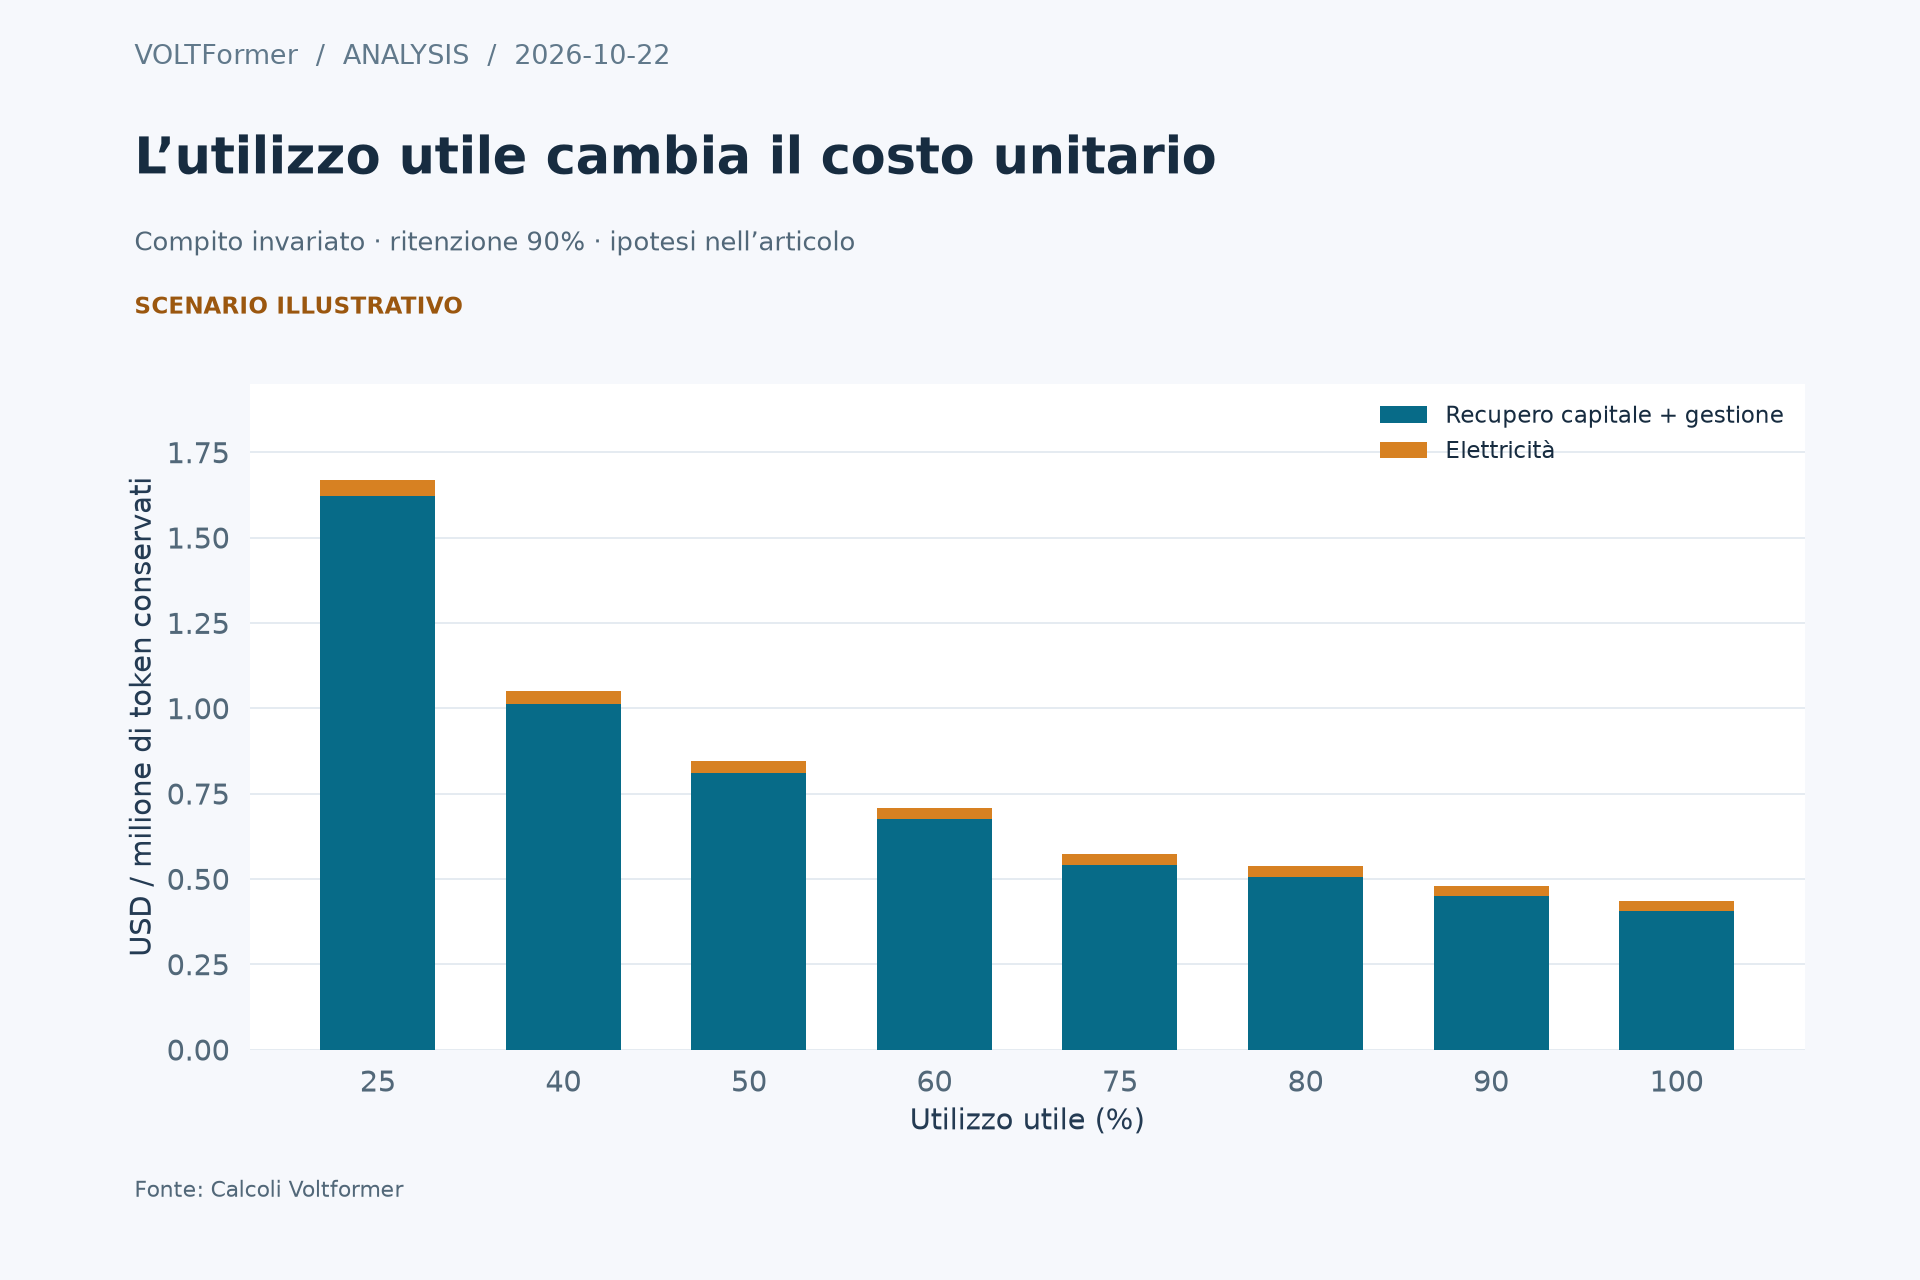
Tutti gli ingressi sono ipotesi, non preventivi o benchmark: K=USD 4m, L=4, F=USD 150,000/year, R=100,000 tokens/s, g=0.90, P0=20 kW, P1=100 kW, h=1.20, p=USD 0.08/kWh. Servono per sensibilità, senza rappresentare prodotti specifici.
| Utilizzo | Energia annua del sito, MWh | Token mantenuti/anno, migliaia di miliardi | Recupero e costi fissi, USD/milione | Elettricità, USD/milione | Totale, USD/milione |
|---|---|---|---|---|---|
| 25% | 420.480 | 0.70956 | 1.621 | 0.047 | 1.668 |
| 50% | 630.720 | 1.41912 | 0.810 | 0.036 | 0.846 |
| 75% | 840.960 | 2.12868 | 0.540 | 0.032 | 0.572 |
| 100% | 1,051.200 | 2.83824 | 0.405 | 0.030 | 0.435 |
Al 50%, la potenza media prima degli ausiliari è 60 kW. Energia: 60 × 1.2 × 8,760 = 630,720 kWh; output mantenuto: 100,000 × 0.5 × 0.9 × 31,536,000 = 1,419,120,000,000 token. Recupero più costi fissi: USD 1.15 milioni; elettricità: USD 50,457.60. La divisione riproduce USD 0.845917 per milione.
Apri il grafico a piena risoluzione
Figura 2. Sensibilità dell'utilizzo ipotizzato, separando fisso ed elettricità. Curva di scenario, non prezzo osservato né punto operativo raccomandato.
Raddoppiare la tariffa al 50% aggiunge circa USD 0.03556 per milione; ridurre utilizzo al 25% con tariffa iniziale aggiunge USD 0.82221. L'energia cresce con il lavoro. Costo unitario minore e consumi aggregati maggiori coesistono senza contraddizione. Altri costi di capitale, lavori o vite possono invertirne il peso.
9. Gli impegni possono sopravvivere al collo di bottiglia
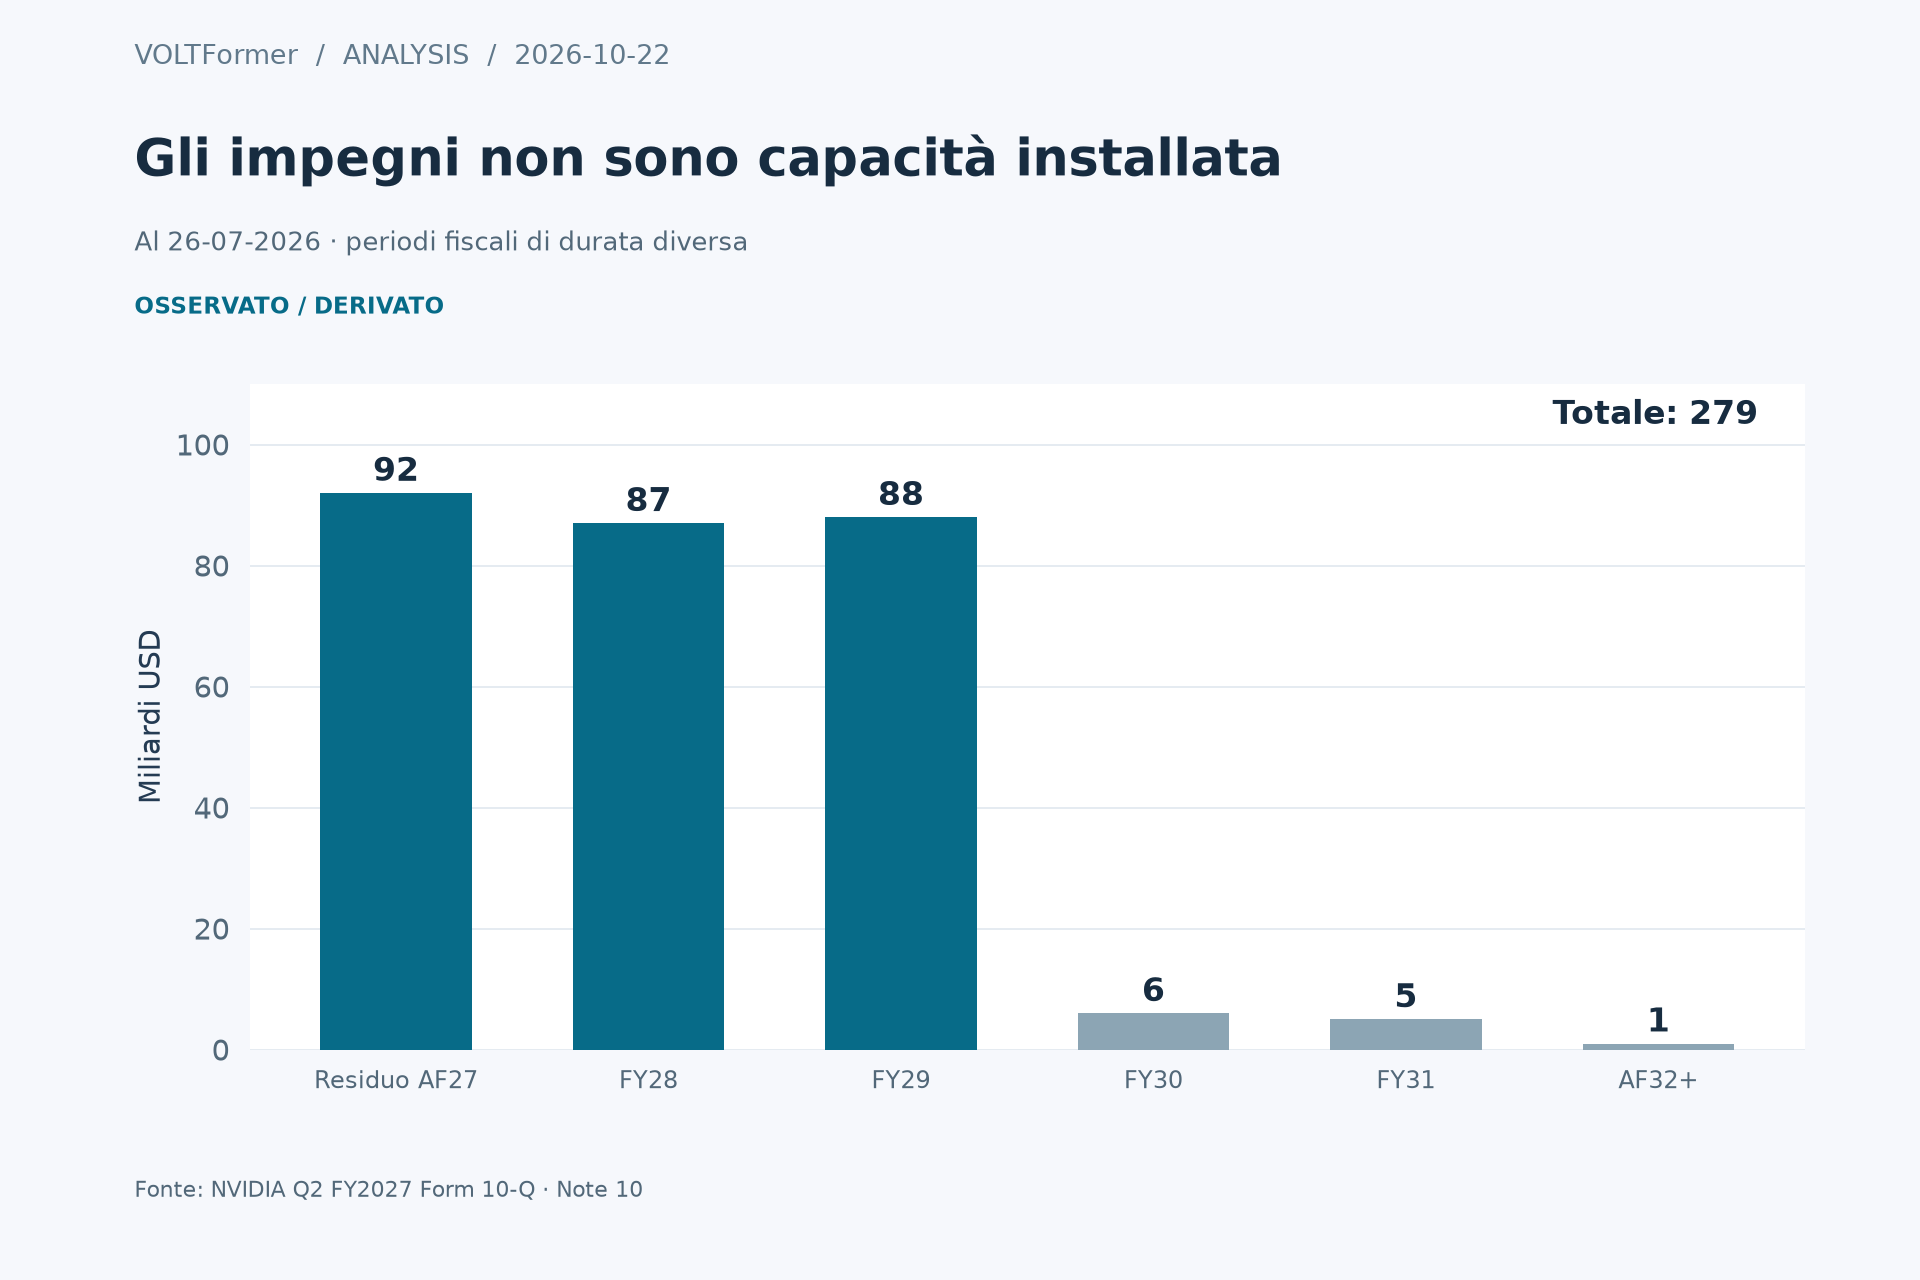
Il 10-Q NVIDIA del trimestre di luglio registra USD 279 miliardi di impegni di fornitura e capacità, contro USD 119 miliardi prima. Il profilo deriva dalla nota 10; alcuni accordi sono modificabili, rinviabili o cancellabili con termini e possibili costi. È esposizione finanziaria, non calendario di consegne. NVIDIA, 10-Q Q2 fiscale 2027, nota 10.
Apri il grafico a piena risoluzione
Figura 1. Impegni al 26 luglio 2026, USD miliardi: residuo FY2027 92; FY2028 87; FY2029 88; FY2030 6; FY2031 5; FY2032 e successivi 1. I valori arrotondati sommano 279. Sono periodi fiscali aziendali, non anni solari.
La capacità cresce con ritardo. I compratori prenotano componenti scarsi; i fornitori impegnano impianti. Se il software riduce risorse per attività, le forniture possono arrivare dopo la scarsità originaria. Viceversa, investimenti insufficienti la prolungano quando più domande crescono insieme. Il ciclo dipende da tempi e flessibilità contrattuale quanto dalla domanda di lungo periodo.
Microsoft evidenzia un'altra questione: portare la vita di data center ed edifici da 15 a 25 anni sposta alcuni leasing futuri fra classificazione finanziaria e operativa. Ha corretto gli investimenti dichiarati per il 2026 a circa USD 175 miliardi indicando invariata l'aspettativa sostanziale al netto dell'effetto. Edifici e GPU richiedono trattamenti distinti. Microsoft, chiamata Q4 FY2026.
Ammortamenti più lunghi cambiano il tempo della spesa contabile, non l'output fisico obsoleto. Valutare cassa recuperabile sulla vita economica, incluse rivendita, riassegnazione e migrazione. Non sommare indiscriminatamente investimenti del fornitore, cliente e finanziamento: possono descrivere più volte le stesse macchine.
Il modello usa recupero lineare per trasparenza. Un modello finanziario deve attualizzare cassa e provare il valore finale. Con recupero annuo uniforme, residuo zero, tasso r e vita L, l'onere è K × r / [1−(1+r)^(−L)], con limite K/L a tasso zero. Obsolescenza rapida aumenta l'onere anche con tariffa invariata. Rinviare ordini preserva informazioni ed evita rimpianti tecnologici, ma costa se i clienti pagherebbero capacità scarsa.
10. Il rimbalzo è una questione empirica
Sia f il miglioramento energetico reale per attività di qualità fissa. Con prezzo proporzionale ed elasticità ε, Q_new/Q_old = f^ε, quindi E_new/E_old = f^(ε−1). Si assumono trasmissione integrale al prezzo, attività invariata e offerta non vincolata.
Un miglioramento quadruplo, con elasticità 0.5, dimezza energia; con 1 la conserva; con 1.5 la raddoppia. Sono casi algebrici, non stime. La trasmissione può essere parziale per capitale o rendite. La domanda può rispondere a qualità e comodità. Più ragionamento cambia l'attività e richiede un altro termine.
Il migliore argomento del rimbalzo è rendere accessibili nuove applicazioni utili. Quello della sostituzione è che instradamento, modelli compatti e saturazione consentano lo stesso valore con meno risorse costose. Possono coesistere tra clienti. Identificarli con consumi per attività ed economia delle coorti, non una crescita aggregata trasformata in legge universale.
11. Tre percorsi condizionali e relative smentite
| Percorso | Condizioni richieste | Conseguenza osservabile | Evidenza che lo indebolisce |
|---|---|---|---|
| La capacità assorbe l'efficienza | Attività pagate e lavoro esigente crescono più dei risparmi | Output remunerato e potenza crescono insieme | Rinnovi deboli, scorte inattive e sconti con offerta sufficiente |
| Efficienza sostituisce macchine | Domanda stabile; instradamento e compressione conservano qualità | Meno ore di acceleratore per successo e acquisti rinviati | Risparmio assente nel traffico reale o più revisione umana |
| Offerta prima della monetizzazione | Impegni lunghi, collaudi riusciti e domanda deludente | Più disponibilità ma rendimenti inferiori | Scarsità qualificata persistente con alto uso pagato |
Non si assegnano probabilità o date. Servono a rendere falsificabili le decisioni. La domanda aggregata può crescere mentre una tecnologia, società o regione è sovracapace. Provare quindi l'esposizione per componente e cliente, con cancellazioni e vita utile esplicite.
12. Che cosa misurare per operatori e investitori
Acquistare rispetto ad attività accettate, qualità e latenza di coda, riconciliando energia IT e del sito misurata. Conservare la definizione del lavoro tra generazioni. Distinguere utilizzo pagato e occupazione tecnica, inventario e allocazione. Includere riserve, inattività e ingegneria di migrazione nel costo del ciclo di vita.
L'investitore deve verificare se margine lordo e incassi raggiungano il capitale installato. Seguire qualificazione, resa dell'incapsulamento, consegne, garanzie e concentrazione insieme ai ricavi. Controllare scarti fra impegni e installazioni, e fra capacità e uso fatturato. Prezzi minori possono indicare efficienza riuscita o incapacità di recuperare capitale.
Il limite principale è la semplicità: un lavoro, potenza lineare, ausiliari costanti, nessuna penalità di coda e finanziamento. I dati pubblici non offrono distribuzioni rappresentative e indipendentemente verificate di utilizzo, prezzi reali degli acceleratori o costi per attività riuscita. Non consentono un costo universale credibile per token. La tesi si indebolirebbe se misure produttive comparabili mostrassero economia insensibile a utilizzo e vincoli di supporto. Fino ad allora, conta il lavoro utile sulla vita dell'asset, con denominatori e perimetri visibili.
Bibliografia primaria e note sulle misure
Fonti consultate il 22 ottobre 2026; nessuna prova eventi successivi. Dichiarazioni operative e finanziarie mantengono i propri perimetri; il rapporto sul modello è un preprint. I grafici uniscono un insieme contrattuale dichiarato e uno scenario riproducibile senza confonderne la classificazione.
1. TSMC, *Third Quarter 2026 Results*, 15 ottobre 2026 — trimestre al 30 settembre; ricavi e mix dei wafer.
2. NVIDIA, *Q2 Fiscal 2027 Results*, 26 agosto 2026 — trimestre al 26 luglio; ricavi di segmento.
3. NVIDIA, *Q2 Fiscal 2027 Form 10-Q*, firmato il 26 agosto 2026 — nota 10, pagina PDF 18; impegni, non spedizioni previste.
4. SK hynix, *2Q26 Financial Results*, 29 luglio 2026 — tempi HBM4 dichiarati; comunicato preliminare.
5. Micron, *Fiscal Q4 and FY2026 Results*, 30 settembre 2026 — esercizio al 3 settembre; investimenti netti riconciliati.
6. MLCommons, *Inference v6.1 Working-Group Analysis*, 17 settembre 2026 — definizioni e copertura del lavoro.
7. MLCommons, *Inference Datacenter Methodology*, documentazione corrente — potenza e disponibilità alla consultazione.
8. AMD, *Introducing AMD Helion*, 12 ottobre 2026 — annuncio, non flotta misurata.
9. Meta Engineering, *Inside Prometheus*, 19 ottobre 2026 — addestramento, affidabilità e allocazione.
10. DeepSeek-AI, *DeepSeek-V4.1-Flash*, v1, 17 settembre 2026 — cache specifica; preprint.
11. Google Developers, *Diffusion-Style Speculative Decoding on TPUs*, 4 maggio 2026 — UCSD e confronto dichiarato.
12. NVIDIA, *Inside Rubin GPU Architecture*, 21 luglio 2026 — confronto del produttore e perimetro.
13. Microsoft, *FY2026 Q4 Earnings Call*, 29 luglio 2026 — vite utili, leasing e investimenti.
14. Kwon et al., *Efficient Memory Management for Large Language Model Serving with PagedAttention*, 12 settembre 2023 — ricerca originale sull'erogazione.
15. Williams, Waterman e Patterson, *Roofline*, UCB/EECS-2008-134, 17 ottobre 2008 — modello storico, non dati di hardware attuale.
16. Meta, *Third-Quarter 2026 Results*, 21 ottobre 2026 — prospettiva di investimento, non capacità realizzata.
- Scope
- Il petrolio dopo la ripresa dell'offerta: consegne, diesel e scorte governano ancora lo shock dei costi del 2026
- Il megawatt scarso: perché il boom elettrico dell'IA è un problema di rete e affidabilità
- Il data center IA è un contratto infrastrutturale con scadenze: utilizzo, elettricità e prezzo del ritardo