La economía del cómputo útil de IA: por qué el silicio eficiente puede coexistir con una factura energética mayor
Un análisis de demanda, eficiencia de modelos, HBM, redes, utilización útil, electricidad y recuperación de capital. Evidencia reciente y escenarios reproducibl
Equipo de Investigación y Edición Voltformer · Evidencia consultada el 22 de octubre de 2026 · Análisis con escenarios condicionales expresamente identificados
La infraestructura de IA entra en una fase económica difícil: los avances de chips y modelos reducen los recursos necesarios para ciertos cálculos mientras los inversores destinan más capital a las máquinas que los realizan. La pregunta relevante es cuántas tareas económicamente útiles completa un sistema, con calidad y demora aceptables, durante su vida operativa. La aritmética máxima, los megavatios anunciados y los tokens brutos solo miden partes del proceso.
Nuestra tesis es condicional. La eficiencia aumenta el valor de la capacidad instalada si demanda, programas e infraestructura de apoyo absorben la mejora. Reduce la necesidad de capacidad adicional si la demanda se satura o sistemas pequeños sustituyen a grandes. El resultado depende de respuesta de demanda, distribución de trabajo, utilización efectiva y calendario de compromisos. Ninguna ley física exige que un token más barato reduzca la electricidad total ni justifique toda compra prevista de aceleradores.
1. Qué demuestra la evidencia primaria más reciente
Los resultados de TSMC del 15 de octubre sitúan los ingresos trimestrales en USD 46.72 mil millones; la tecnología de 2 nanómetros aportó el 8% de ingresos de obleas. Son ventas fabriles y mezcla de producto, no sistemas de IA instalados. TSMC, tercer trimestre de 2026.
NVIDIA comunicó USD 89.0 mil millones de ingresos Data Center para el trimestre terminado el 26 de julio, un 117% más interanual. Las ventas del proveedor prueban compras; la rentabilidad del cliente requiere otra evidencia. NVIDIA, segundo trimestre fiscal de 2027.
| Evidencia fechada | Observación o afirmación | Clasificación | Qué sigue sin probarse |
|---|---|---|---|
| 29 de julio: SK hynix | Envíos masivos de HBM4 iniciados en Q2 | Desarrollo operativo comunicado por empresa | Volumen cualificado para cada comprador comunicado |
| 30 de septiembre: Micron | Inversión neta FY2026 de USD 27.367 mil millones | Medida no GAAP comunicada | Producción y rendimiento de capacidad futura resultados y conciliación |
| 17 de septiembre: MLCommons | Inference v6.1 añade RAG integral y Agentic Edge | Publicación de prueba comparativa | Economía operativa real análisis del grupo |
| 12 de octubre: AMD | Helion combina cómputo configurable y selección de modelos | Anuncio de producto | Flota instalada y eficiencia obtenida anuncio |
| 19 de octubre: Meta | Primera fase de Prometheus terminada y usada para entrenamiento | Despliegue comunicado por operador | Utilización sectorial relato de ingeniería |
| 21 de octubre: Meta | Previsión de inversión FY2026 acotada a USD 135–145 mil millones, incluyendo principal de arrendamientos financieros | Previsión directiva | Rentabilidad realizada resultados |
La matriz es deliberadamente heterogénea: finanzas, operaciones desplegadas, investigación y anuncios responden a preguntas distintas. Intercambiarlos crea la impresión falsa de que se han completado todas las etapas entre pedir obleas y vender servicios rentables.
2. Medir demanda en tareas completadas
Un token es una unidad contable de ingeniería, no producción económica constante. Tokenizadores distintos dividen de forma diferente un mismo material. Una respuesta larga puede aportar valor o desperdicio. Un agente puede llamar repetidamente al modelo esperando herramientas, reintentando fallos o revisando trabajo. El ingreso por token también depende de descuentos, caché y proporción de entradas y salidas.
Un modelo útil distingue llegadas de tareas, llamadas por tarea, longitudes de entrada y salida y probabilidad de éxito. Para tareas fijas, razonar más puede aumentar cálculo y reducir revisión humana. Un modelo pequeño puede eliminar gran parte del cálculo sin reducir éxito. Ambas posibilidades deben probarse en la distribución real del comprador.
Defínase tarea aceptada mediante corrección evaluada externamente, límite de latencia y escalado explícito. Regístrense acelerador, CPU y energía de todos los reintentos. El proveedor puede producir más tokens sin mejorar coste por tarea exitosa del cliente. También puede producir menos con mejor economía porque la selección evita generación innecesaria. Por ello, uso y productividad deben informarse por separado.
3. El rendimiento del silicio es un flujo restringido
Roofline relaciona rendimiento aritmético realizable con cálculo, ancho de memoria e intensidad aritmética. Las operaciones por segundo no superan el menor valor entre pico de operaciones y bytes por segundo multiplicados por operaciones por byte. Es un límite para entender cuellos de botella, no promesa de rendimiento de aplicación. Williams, Waterman y Patterson, Berkeley, 2008.
Extiéndase el razonamiento al sistema. Procesar instrucciones, generar tokens, seleccionar expertos y comunicar exigen recursos distintos. Un motor aritmético rápido no compensa memoria insuficiente. Una interconexión libre no elimina dependencias secuenciales. Aceleradores comprados que esperan firmware, red cualificada o puesta en servicio no entregan trabajo.
| Restricción | Unidad relevante | Consecuencia económica | Verificación |
|---|---|---|---|
| Cálculo matricial | Operaciones/s a precisión indicada | Un techo de ejecución | Mismo modelo, precisión y exactitud |
| Capacidad de memoria | Bytes para pesos y estado | Limita residencia y concurrencia | Capacidad después de sobrecarga de ejecución |
| Movimiento de memoria | Bytes/s sostenidos | Puede gobernar generación | Trazas de aplicación, no terminales de pico |
| Interconexión interna y entre nodos | Bytes/s y latencia | Modifica sincronización e inactividad | Colectivas con contención realista |
| Fiabilidad | Trabajo terminado por intervalo | Determina producción útil instalada | Reinicios, puntos de control y repuestos |
| Demanda comercial | Tareas aceptadas/hora | Determina ingresos de capacidad técnica | Uso pagado y cohortes de renovación |
Las restricciones interactúan. Aumentar lotes reutiliza pesos pero puede empeorar respuesta. Distribuir modelos resuelve capacidad y añade comunicación. La configuración económica se sitúa en una frontera de calidad, demora y coste; el mayor rendimiento titular puede quedar fuera.
4. Escasez de HBM y compresión actúan simultáneamente
Capacidad y ancho de banda HBM son restricciones distintas. Comprimir estado admite más peticiones concurrentes, pero no elimina automáticamente leer pesos o intercambiar tokens seleccionados. Lotes grandes convierten memoria ahorrada en rendimiento. Contextos largos pueden absorber ese ahorro.
El preprint V4.1-Flash de DeepSeek-AI del 17 de septiembre comunica caché KV global residente en HBM de 890 bytes por token, aproximadamente un cuarto de V4-Flash; distingue estado persistente fuera de HBM. Es una afirmación específica del modelo, sin ahorro eléctrico de flota demostrado independientemente. Informe técnico DeepSeek-AI V4.1-Flash, v1.
La implicación es cambiar la renta de escasez de memoria de ciertos trabajos. Si la demanda cabe en menos dispositivos, puede aplazarse compra. Si estaba limitada por contexto o concurrencia, la mejora hace viables servicios nuevos. Los proveedores pueden vivir demanda fuerte con compresión rápida, especialmente si aplicaciones consumen más estado por tarea o más tareas resultan asequibles.
Para comprar, preguntar qué nivel de memoria se ahorra, si reconstruir el estado consume cálculo y si la descarga traslada presión a memoria anfitriona, almacenamiento o red. Menos bytes HBM por petición es útil; su valor depende del siguiente recurso vinculante.
5. El software de servicio cambia el denominador
PagedAttention aportó gestión de cachés KV crecientes y decrecientes con menos fragmentación y duplicación. Mejora la asignación del sistema, no la capacidad aritmética nominal de la GPU. Kwon y colaboradores, PagedAttention/vLLM, 2023.
En mayo de 2026, Google describió una implementación de UCSD de decodificación especulativa por difusión en TPU, con mejora media de 3.13 veces en tokens por segundo para la comparación indicada. Es un resultado de trabajo medido, no multiplicador energético universal. Google Developers, implementación DFlash.
La especulación añade borradores para reducir iteraciones caras del modelo objetivo. Depende de aceptación, compatibilidad y lotes. Cuantizar reduce datos preservando la calidad exigida. Seleccionar modelos evita llamadas grandes, pero errores pueden escalar. Separar preprocesado y generación ajusta recursos, pero añade transferencia de estado.
No se deben multiplicar aceleraciones de experimentos separados. Dos optimizaciones pueden eliminar el mismo cuello, competir por memoria o perder ventaja con otro lote. Remídase el sistema combinado con tráfico previsto, latencia de cola y recuperación de fallos. El contrafactual es la mejor alternativa viable, no una referencia histórica sin optimizar.
La aritmética es reveladora. Si media ejecución mejora diez veces y el resto queda igual, la aceleración total es 1 / [0.5 + 0.5/10] = 1.818, no diez veces. Con fracción invariable a y mejora s, el límite es 1 / [a + (1−a)/s]. Herramientas y comunicación pueden constituir esa fracción. Se asume ausencia de solapamiento y trabajo adicional: expone el denominador, no predice un sistema.
6. Utilización tiene significados incompatibles
Ocupación, asignación, tiempo programado, rendimiento útil de entrenamiento y utilización generadora de ingresos son distintos. Una GPU asignada puede esperar datos. Un núcleo terminado puede pertenecer a un trabajo reiniciado después. Una solicitud exitosa puede consumir créditos promocionales gratuitos.
Meta comunica en octubre más del 85% de rendimiento útil para preentrenamiento y más del 90% para aprendizaje por refuerzo. Describe 37,656 GPU aprovisionadas para 32,768 activas. La aritmética da un 14.9% de inventario sobre activas, o reserva del 13.0% sobre inventario aprovisionado: distintos denominadores. Ninguno estima utilización sectorial. Meta, Prometheus.
Las reservas pueden ser racionales: elevan capital por dispositivo activo y reducen coste esperado de interrupción. Dominios de fallo grandes hacen valiosa la fiabilidad; reservar puede mejorar producción útil y reducir una ratio superficial. Debe contarse todo el equipo propio y el trabajo perdido en el mismo período. No multiplicar porcentajes de rendimiento y reserva sin conocer denominadores y solapamiento.
7. De tokens por julio al coste entregado
MLCommons especifica que la potencia validada cubre AC media de todo el sistema en la toma; TDP o potencia nominal no son esa medición. Separa también sistemas disponibles, anticipos y configuraciones investigadoras. Metodología MLPerf Inference Datacenter.
La arquitectura NVIDIA de julio presenta hasta diez veces más rendimiento agéntico por energía con trabajo interno de mezcla de expertos de dos billones de parámetros. Identifica el perímetro del fabricante; no prueba que toda factura se divida por diez. NVIDIA, arquitectura Rubin.
La energía de instalación añade refrigeración y pérdidas. El coste entregado añade recuperación de capital, mantenimiento, operación y capacidad preparada. El carbono depende además de cuándo y dónde se suministra electricidad. PPA o certificado anual no miden por sí solos emisiones marginales de una inferencia. Son columnas distintas.
Para un bloque expresamente hipotético, sean utilización u, retención productiva g, rendimiento ocupado R tokens/s, potencias IT medias en reposo y trabajo P0 y P1 kW y multiplicador auxiliar h. Con 8,760 horas y 31,536,000 segundos por año supuesto:
T = R × u × g × 31,536,000 tokens/año
E = h × [P0 + u(P1 − P0)] × 8,760 kWh/año
C_million = 1,000,000 × [K/L + F + pE] / T dólares por millón de tokens retenidos.
K es capital en dólares; L, recuperación lineal en años; F, operación fija anual; p, dólares/kWh. Se excluyen financiación, impuestos y residual. Toda energía en reposo se asigna al bloque; g refleja pérdida de producción útil sin reducir energía ya consumida.
8. Escenario reproducible: utilización frente a tarifa
Todos los datos siguientes son supuestos, no ofertas ni pruebas: K=USD 4m, L=4, F=USD 150,000/year, R=100,000 tokens/s, g=0.90, P0=20 kW, P1=100 kW, h=1.20, p=USD 0.08/kWh. Sirven para sensibilidad y no representan un producto concreto.
| Utilización | Energía anual, MWh | Tokens retenidos/año, billones | Recuperación y operación fija, USD/millón | Electricidad, USD/millón | Total, USD/millón |
|---|---|---|---|---|---|
| 25% | 420.480 | 0.70956 | 1.621 | 0.047 | 1.668 |
| 50% | 630.720 | 1.41912 | 0.810 | 0.036 | 0.846 |
| 75% | 840.960 | 2.12868 | 0.540 | 0.032 | 0.572 |
| 100% | 1,051.200 | 2.83824 | 0.405 | 0.030 | 0.435 |
Al 50%, la media es 60 kW antes de auxiliares. Energía anual: 60 × 1.2 × 8,760 = 630,720 kWh; producción retenida: 100,000 × 0.5 × 0.9 × 31,536,000 = 1,419,120,000,000 tokens. Recuperación y operación fija: USD 1.15 millones; electricidad: USD 50,457.60. Dividir reproduce USD 0.845917 por millón.
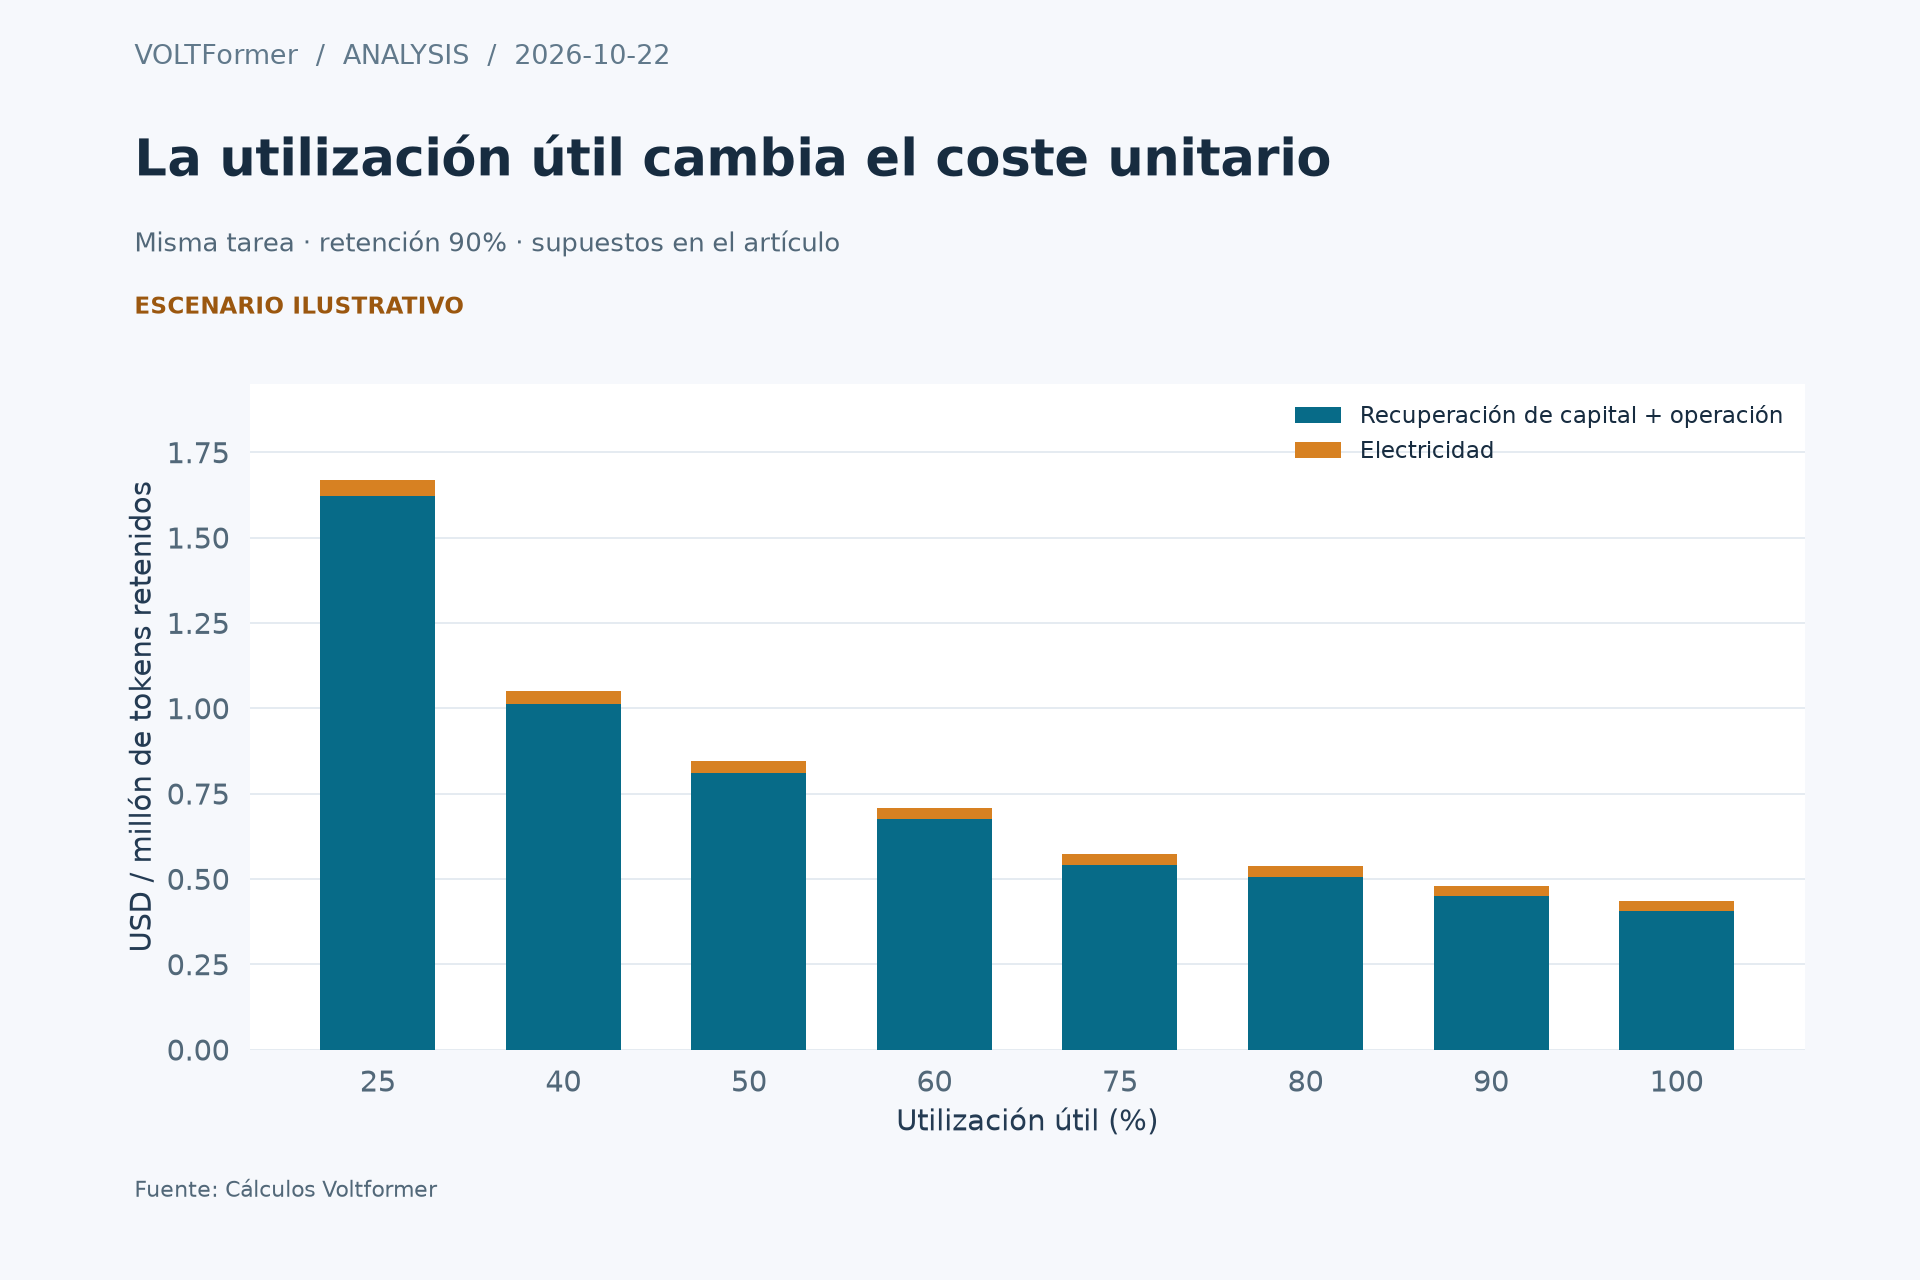
Abrir gráfico a resolución completa
Figura 2. Sensibilidad de utilización supuesta, separando fijo y electricidad. Es escenario, no precio observado ni punto recomendado.
Duplicar tarifa al 50% añade unos USD 0.03556 por millón; bajar utilización al 25% con tarifa original añade USD 0.82221. La energía aumenta al trabajar más. Menor coste unitario y mayor consumo total coexisten sin contradicción. Otros capitales, trabajos o vidas útiles pueden invertir la importancia relativa.
9. Los compromisos sobreviven a un cuello de botella
El 10-Q de NVIDIA del trimestre de julio registra USD 279 mil millones de compromisos de suministro y capacidad, frente a USD 119 mil millones antes. El vencimiento proviene de la nota 10; ciertos acuerdos admiten ajustes, reprogramación o cancelación con condiciones y posibles costes. Es exposición financiera, no calendario de capacidad entregada. NVIDIA, 10-Q Q2 fiscal 2027, nota 10.
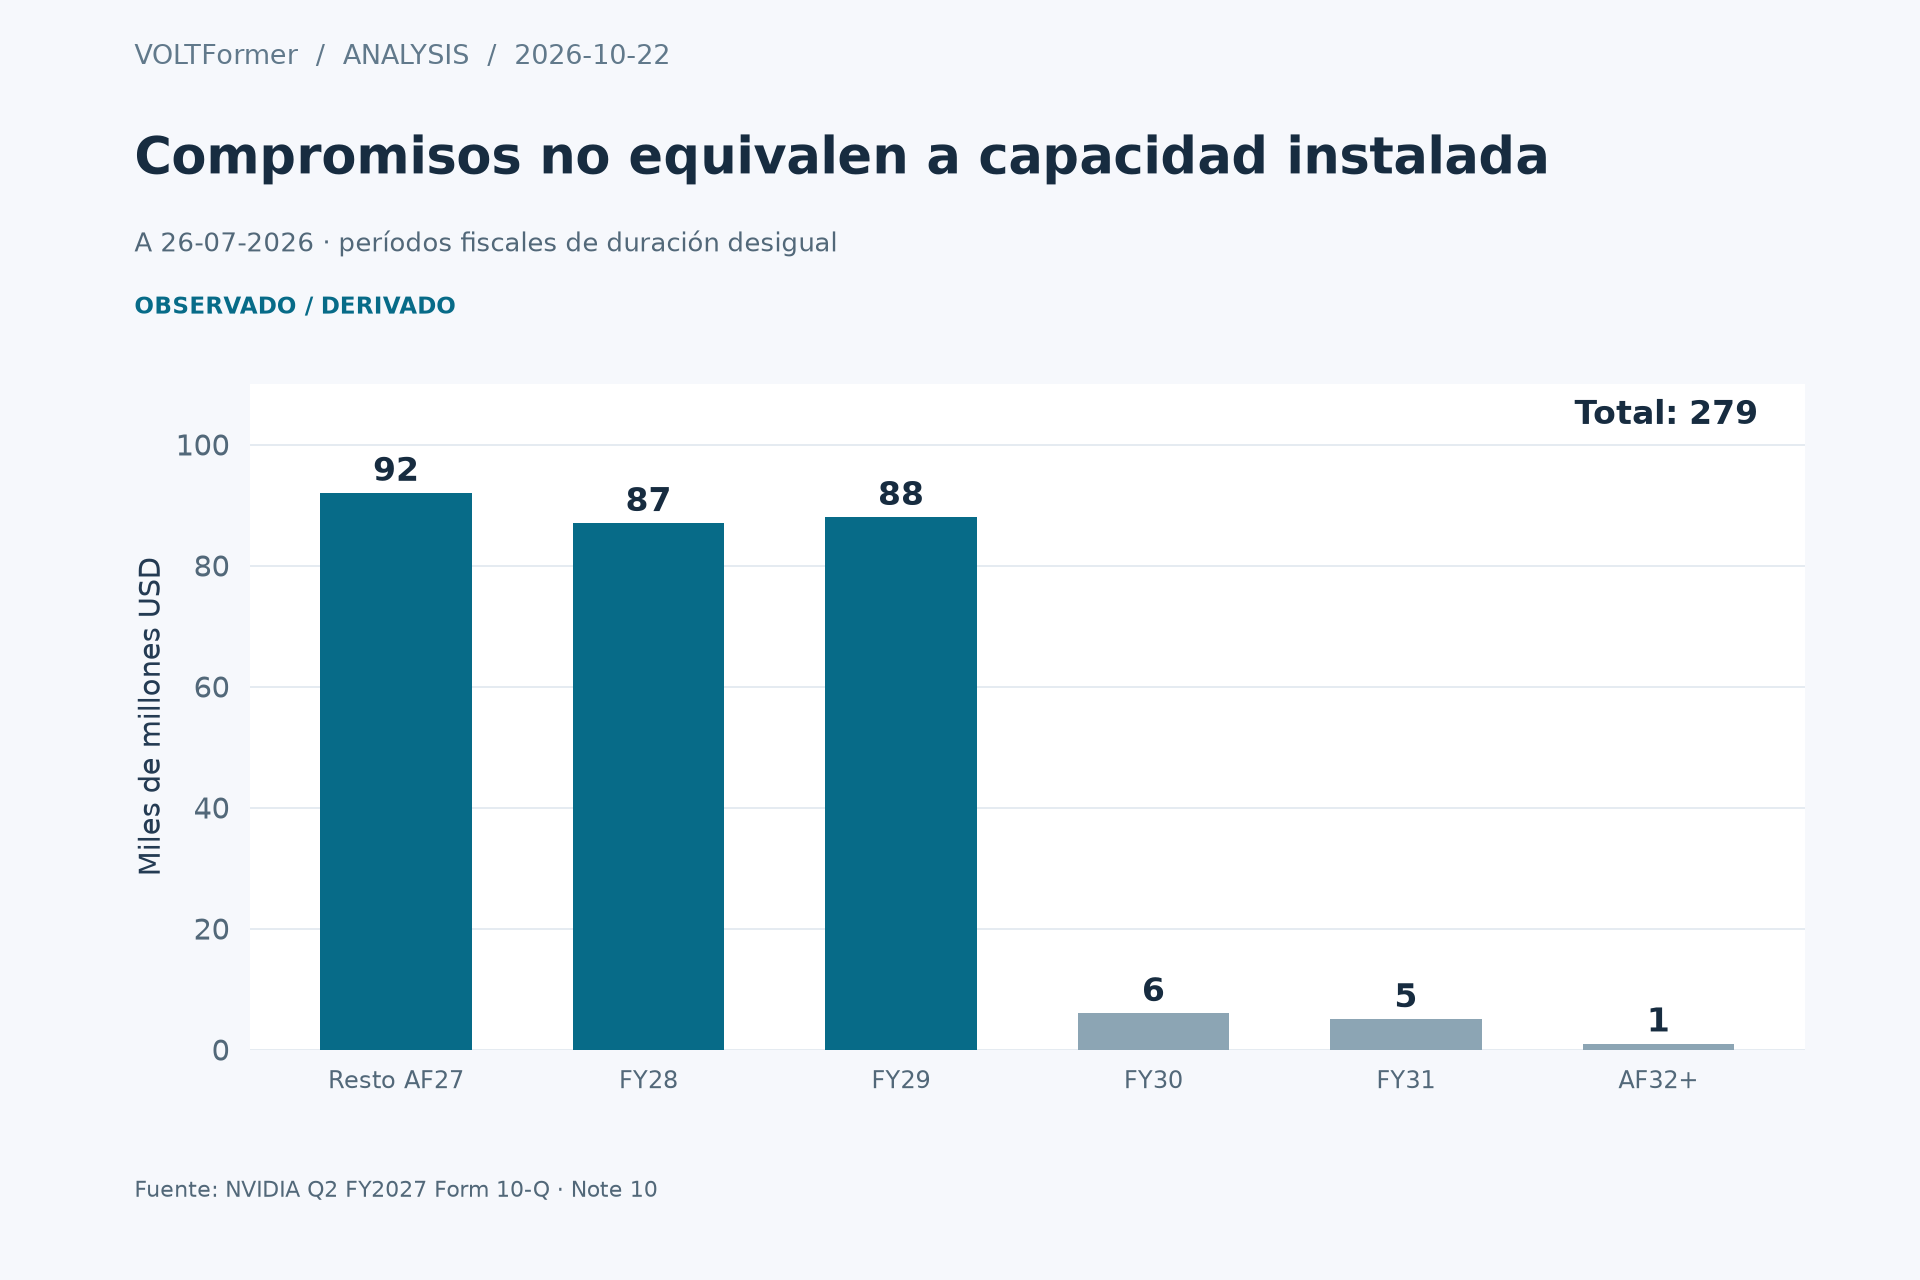
Abrir gráfico a resolución completa
Figura 1. Compromisos al 26 de julio de 2026, USD mil millones: resto FY2027 92; FY2028 87; FY2029 88; FY2030 6; FY2031 5; FY2032 y posteriores 1. Los importes redondeados suman 279. Son ejercicios fiscales propios, no años naturales.
La capacidad llega con retraso. Los compradores reservan componentes escasos y proveedores comprometen equipos e instalaciones. Si el software reduce recursos por tarea, la oferta contratada puede llegar tras aliviarse la escasez inicial. Una inversión insuficiente también puede prolongarla si crecen varias demandas. El ciclo depende tanto de plazos y flexibilidad contractual como de demanda a largo plazo.
Microsoft muestra otra cuestión: al pasar edificios y centros de datos de 15 a 25 años de vida útil, algunas futuras operaciones pasan de arrendamiento financiero a operativo. Ajustó la inversión comunicada para 2026 a unos USD 175 mil millones indicando que, salvo ese efecto, la inversión subyacente no cambiaba. Edificios y GPU requieren separación. Microsoft, llamada Q4 FY2026.
Depreciar durante más tiempo cambia cuándo se reconoce gasto, no mejora producción física obsoleta. Debe probarse caja recuperable durante vida económica, incluida reventa, reasignación y migración. Tampoco se suman sin criterio inversión del proveedor, gasto del cliente y compromisos financieros: pueden describir el mismo equipo más de una vez.
El escenario usa recuperación lineal por transparencia. Un modelo financiero debe descontar caja y probar terminal. Para recuperación anual uniforme, residual cero, descuento r y vida L, el cargo es K × r / [1−(1+r)^(−L)], con límite K/L a descuento cero. Obsolescencia rápida aumenta recuperación exigida aun con tarifa fija. Retrasar compras conserva información y evita arrepentimiento tecnológico, pero cuesta cuando clientes pagarían por capacidad escasa.
10. El rebote es una cuestión empírica
Sea f una mejora real de eficiencia energética para tarea de calidad fija. Con precio proporcional y elasticidad ε, Q_new/Q_old = f^ε, de donde E_new/E_old = f^(ε−1). Supone traslado íntegro al precio, tarea idéntica y oferta sin restricción.
Con mejora cuádruple, elasticidad 0.5 reduce energía a la mitad; 1 la mantiene; 1.5 la duplica. Son casos algebraicos, no estimaciones. El traslado puede ser parcial por capital o rentas de escasez. La demanda puede responder a calidad y comodidad. Más razonamiento por tarea cambia la propia tarea y necesita otro término.
El argumento más fuerte del rebote es hacer asequibles aplicaciones útiles nuevas. El de sustitución es que selección, modelos compactos y saturación permiten igual valor con menos recursos caros. Ambos caben en clientes distintos. Deben identificarse mediante consumo por tarea y economía de cohortes, no una tasa agregada convertida en ley universal.
11. Tres caminos condicionales y sus refutaciones
| Camino | Condiciones necesarias | Implicación observable | Evidencia que lo debilita |
|---|---|---|---|
| La capacidad absorbe eficiencia | Tareas pagadas y trabajo exigente crecen más que ahorro | Producción rentable y potencia suben juntas | Renovación débil, inventario inactivo y descuentos con oferta suficiente |
| Eficiencia sustituye equipos | Demanda estable; selección y compresión mantienen calidad | Menos horas de acelerador por tarea y compras aplazadas | Ahorro desaparece con tráfico real o aumenta revisión humana |
| Oferta anterior a monetización | Compromisos largos, puesta en servicio exitosa y demanda decepcionante | Mejora disponibilidad y cae rentabilidad realizada | Escasez cualificada persistente con alta utilización pagada |
No se asignan probabilidades ni fechas. Su valor es hacer falsables las decisiones. Puede crecer demanda agregada y sobrar una arquitectura, proveedor o región. La exposición debe probarse por componente y cliente, con cancelación y vida útil explícitas.
12. Qué deben medir operadores e inversores
El operador debe comprar frente a tareas aceptadas, calidad y latencia de cola, conciliando energía IT y de instalación medida. Mantener tarea al comparar generaciones. Separar utilización pagada y ocupación técnica, inventario y asignación activa. Incluir repuestos, reposo y migración en coste de ciclo de vida.
El inversor debe probar si beneficio bruto y cobros alcanzan capital instalado. Seguir cualificación, rendimiento de encapsulado, plazos, garantías y concentración junto con ventas del proveedor. Vigilar brechas entre compromisos y despliegue, y entre capacidad y uso facturable. Precios menores pueden expresar eficiencia exitosa o incapacidad de recuperar capital.
El límite principal es la simplicidad: un trabajo, potencia lineal, auxiliares constantes, sin cola ni financiación. La información pública no ofrece distribución representativa auditada de uso de flota, compras realizadas ni economía por tarea exitosa. Impide un coste universal creíble por token. La tesis se debilitaría con mediciones productivas comparables cuya economía fuera insensible a utilización e infraestructura de apoyo. Mientras tanto, el análisis defendible es trabajo útil durante la vida del activo, con denominadores y perímetros visibles.
Bibliografía primaria y notas de medición
Fuentes consultadas el 22 de octubre de 2026; ninguna prueba hechos posteriores. Las declaraciones empresariales conservan perímetros; el artículo de modelo es preprint. Las figuras combinan un conjunto contractual comunicado y un escenario reproducible sin mezclar clasificaciones.
1. TSMC, *Third Quarter 2026 Results*, 15 de octubre de 2026 — trimestre terminado el 30 de septiembre; ingresos y tecnología de obleas.
2. NVIDIA, *Q2 Fiscal 2027 Results*, 26 de agosto de 2026 — trimestre terminado el 26 de julio; ingresos del segmento.
3. NVIDIA, *Q2 Fiscal 2027 Form 10-Q*, firmado el 26 de agosto de 2026 — nota 10, página PDF 18; compromisos, no envíos previstos.
4. SK hynix, *2Q26 Financial Results*, 29 de julio de 2026 — calendario HBM4 comunicado; finanzas preliminares.
5. Micron, *Fiscal Q4 and FY2026 Results*, 30 de septiembre de 2026 — ejercicio terminado el 3 de septiembre; conciliación de inversión neta.
6. MLCommons, *Inference v6.1 Working-Group Analysis*, 17 de septiembre de 2026 — definiciones y cobertura de tareas.
7. MLCommons, *Inference Datacenter Methodology*, documentación vigente — potencia y disponibilidad al consultar.
8. AMD, *Introducing AMD Helion*, 12 de octubre de 2026 — anuncio, no medición de flota.
9. Meta Engineering, *Inside Prometheus*, 19 de octubre de 2026 — entrenamiento, fiabilidad y asignación.
10. DeepSeek-AI, *DeepSeek-V4.1-Flash*, v1, 17 de septiembre de 2026 — caché específica; preprint.
11. Google Developers, *Diffusion-Style Speculative Decoding on TPUs*, 4 de mayo de 2026 — implementación UCSD y comparación especificada.
12. NVIDIA, *Inside Rubin GPU Architecture*, 21 de julio de 2026 — comparación del proveedor y perímetro.
13. Microsoft, *FY2026 Q4 Earnings Call*, 29 de julio de 2026 — vidas, arrendamientos e inversión prevista.
14. Kwon et al., *Efficient Memory Management for Large Language Model Serving with PagedAttention*, 12 de septiembre de 2023 — investigación original de servicio.
15. Williams, Waterman y Patterson, *Roofline*, UCB/EECS-2008-134, 17 de octubre de 2008 — modelo fundacional histórico, no hardware actual.
16. Meta, *Third-Quarter 2026 Results*, 21 de octubre de 2026 — inversión futura, no despliegue realizado.
- Scope
- Petróleo tras el repunte de la oferta: por qué la entrega, el diésel y los inventarios siguen determinando el choque de costes de 2026
- El megavatio escaso: por qué el auge eléctrico de la IA es un problema de red y fiabilidad
- El centro de datos de IA es un contrato de infraestructura con plazos: utilización, electricidad y precio del retraso